Reti convoluzionali, CIFAR-10 e complessità
Nota: questo articolo è disponibile anche come file PDF.
Introduzione
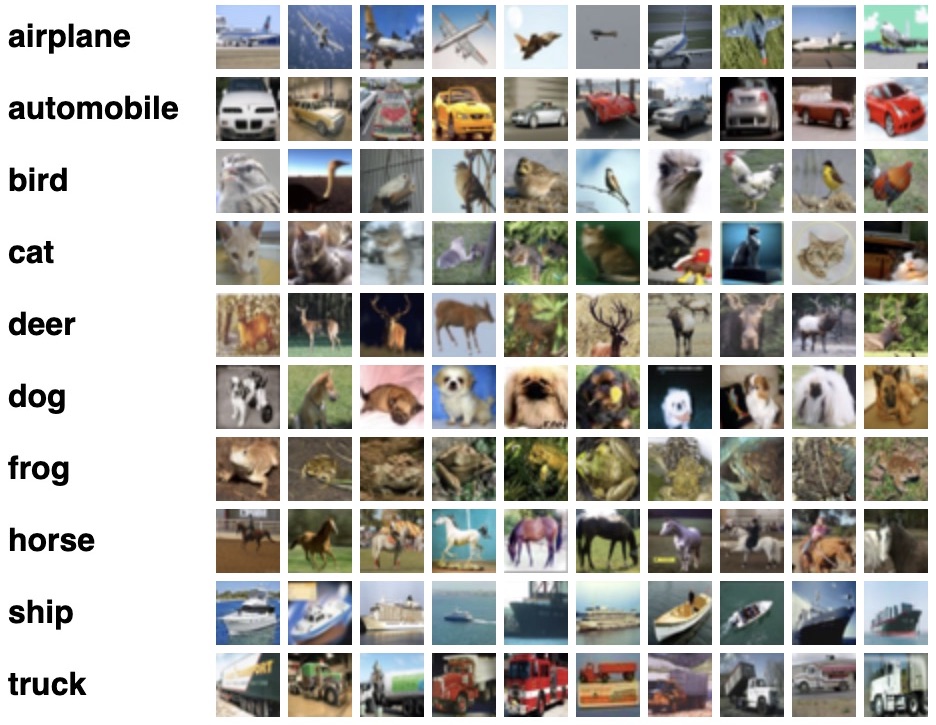
In un task di Image Classification, l’obiettivo è attribuire a un’immagine una delle etichette tra quelle disponibili. A differenza di molti altri classici task di computer vision, questa è l’unica informazione di cui abbiamo bisogno: non dobbiamo indicare dove si trova l’oggetto nell’immagine con una bounding box, né definire classi di appartenenza pixel per pixel. Un’immagine, una classe tra un insieme di classi predefinite, senza sovrapposizioni. Il dataset usato in questo progetto è CIFAR-10, contenente 60000 immagini a colori di dimensione 32x32 pixel1. Una delle peculiarità di questo dataset è che, visivamente, le classi sono completamente mutuamente esclusive; la stessa immagine non conterrà mai sia un’automobile sia un camion, due delle categorie di immagini presenti nel dataset. È stato creato come sottoinsieme del dataset 80 Million Tiny Images2, ed è ampiamente usato per il benchmarking degli algoritmi di visione. Le classi presenti sono aeroplani, automobili, uccelli, gatti, cervi, cani, rane, cavalli, navi e camion; il dataset è inoltre artificialmente bilanciato, con 6000 immagini per classe, quindi non avremo problemi legati allo sbilanciamento delle classi durante la classificazione. Per tutte le ragioni appena elencate, è un dataset comunemente usato come benchmark per gli algoritmi di classificazione; la sua struttura regolare consente un’ottima ripetibilità degli esperimenti e rende facile confrontare metriche simili tra più architetture. Nel nostro caso, per affrontare il task di classificazione, useremo due diverse architetture di reti convoluzionali. Vedremo un primo approccio che fa uso del transfer learning, impiegando la rete convoluzionale ResNet-18 come feature extractor pre-addestrato, e una seconda architettura convoluzionale custom, realizzata ad hoc per il problema — sebbene non esistano linee guida unificate per la definizione di tali architetture, solo alcune best practice. Infine, vedremo come le risorse computazionali disponibili possano diventare molto rapidamente un collo di bottiglia in questo tipo di applicazioni.
Lavori correlati
Esiste una vastissima letteratura nell’ambito dell’Image Classification tramite reti convoluzionali; una rapida ricerca su motori come Google Scholar restituisce decine di migliaia di risultati tra pubblicazioni e libri3. Alcune delle architetture più consolidate in Computer Vision per i task di Image Classification sono VGGNet4, AlexNet5, GoogLeNet6 e ResNet7. Quest’ultima è la rete che useremo per il nostro esperimento, ed è anche l’architettura che ha dato inizio alla cosiddetta “rivoluzione della profondità” delle reti convoluzionali. Sebbene la versione che useremo sia composta da 18 layer, esistono versioni di ResNet con più di mille layer8. Una delle pubblicazioni più recenti, del 20199, riporta un’accuratezza fino al 99% per la classificazione di immagini su CIFAR-10; si può quindi affermare che si tratta di un dataset testato in modo estremamente approfondito.
Approccio proposto
Il dataset CIFAR-10 è strutturato in 50000 immagini di training e 10000 immagini di test, anch’esse bilanciate tra le classi. Abbiamo quindi a disposizione 5000 immagini di training e 1000 immagini di test per ogni classe.
Primo approccio: transfer learning, usando ResNet-18 come feature extractor. Il nostro primo approccio sarà quello di usare una strategia di transfer learning: prenderemo una rete convoluzionale pre-addestrata dalla libreria PyTorch10 e la riutilizzeremo come feature extractor. In questo modo non dovremo addestrare la rete da zero per trovare tutti i pesi da assegnare ai numerosi layer convoluzionali. Grazie a librerie come PyTorch questa operazione è molto semplice: possiamo importare direttamente la rete e sostituire l’ultimo layer fully connected con un layer denso avente 10 nodi di output, cioè tanti quante sono le classi da discriminare. Possiamo poi congelare i pesi dei neuroni dei layer convoluzionali, lasciando all’ottimizzatore solo il lavoro sull’ultimo layer fully connected. Una delle peculiarità di ResNet che la rende particolarmente performante è l’introduzione del blocco residuale, si veda la Fig. 1.
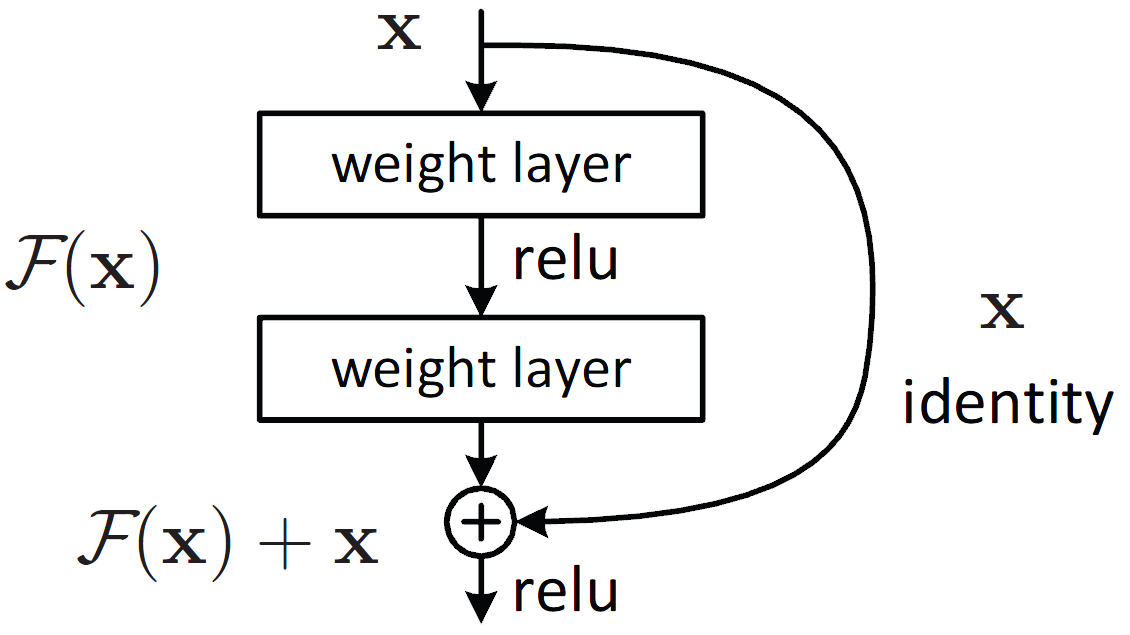
Esso consiste semplicemente nell’inoltrare l’attivazione di un certo layer a un layer più profondo della rete; come possiamo vedere in Fig. 1, il risultato dell’attivazione proveniente da un layer precedente viene sommato a quello di un layer più profondo. Questo semplice accorgimento evita problemi con il gradiente numerico in fase di ottimizzazione, e previene la perdita di informazione durante l’addestramento di reti molto profonde. Vedremo più avanti che, sebbene questo metodo renda possibile riutilizzare conoscenza pregressa senza dover ripartire ogni volta da zero con l’addestramento di una rete convoluzionale, il transfer learning non è sempre una procedura efficiente per risolvere un task di classificazione di immagini.
Secondo approccio: rete convoluzionale custom. Come secondo metodo, useremo una rete convoluzionale creata appositamente per il task e addestrata sul dataset da zero. I suoi layer sono definiti come segue:
- INPUT
- CONVOLUTIONAL 1
- Numero di filtri: \(32\)
- Dimensione del kernel: \( 3\times3 \)
- Padding: SAME
- Stride: 1px
- RELU
- MAX POOLING 2D
- CONVOLUTIONAL 2
- Numero di filtri: \(64\)
- Dimensione del kernel: \( 3\times3 \)
- Padding: SAME
- Stride: 1px
- RELU
- MAX POOLING 2D
- CONVOLUTIONAL 3
- Numero di filtri: \(128\)
- Dimensione del kernel: \( 3\times3 \)
- Padding: SAME
- Stride: 1px
- RELU
- FULLY CONNECTED 1
- Nodi di input: \( 8192 \;(8\times8\times128) \)
- Nodi di output: \(512\)
- BATCH NORMALIZATION
- RELU
- DROPOUT (\(p=0.5\))
- FULLY CONNECTED 2
- Nodi di input: \(512\)
- Nodi di output: \( 10 \)
- DROPOUT (\(p=0.5\))
La funzione di loss usata per tutti gli addestramenti è la Cross Entropy Loss, detta anche Log Loss che, nel caso generico multi-classe con \(n\) classi, è formulata come segue: $$L=-\frac{1}{n}\sum_{i=1}^ny_{i}\log(p_{i})$$ dove \(p_i\) denota la probabilità softmax per la classe \(i\), e \(y_i\) è la truth label. Non è affatto l’unica funzione di loss disponibile; ne esistono altre come la hinge loss, la logistic loss e altre ancora, ma questa è certamente tra le più usate; come affermato in Pattern Recognition and Machine Learning11, usare la funzione di errore cross-entropy invece della somma dei quadrati per un problema di classificazione porta a un addestramento più rapido oltre che a una migliore generalizzazione. Dopo i primi due layer convoluzionali, abbiamo usato il MAX POOLING per ridurre la risoluzione dei filtri e rendere la rete invariante alle traslazioni dell’input, prendendo solo il massimo dei valori della regione di appartenenza. Questo aumenta anche il receptive field dei neuroni più profondi, permettendo alla rete di gestire più informazione semantica alla volta nei filtri successivi, creando feature map progressivamente più complesse.
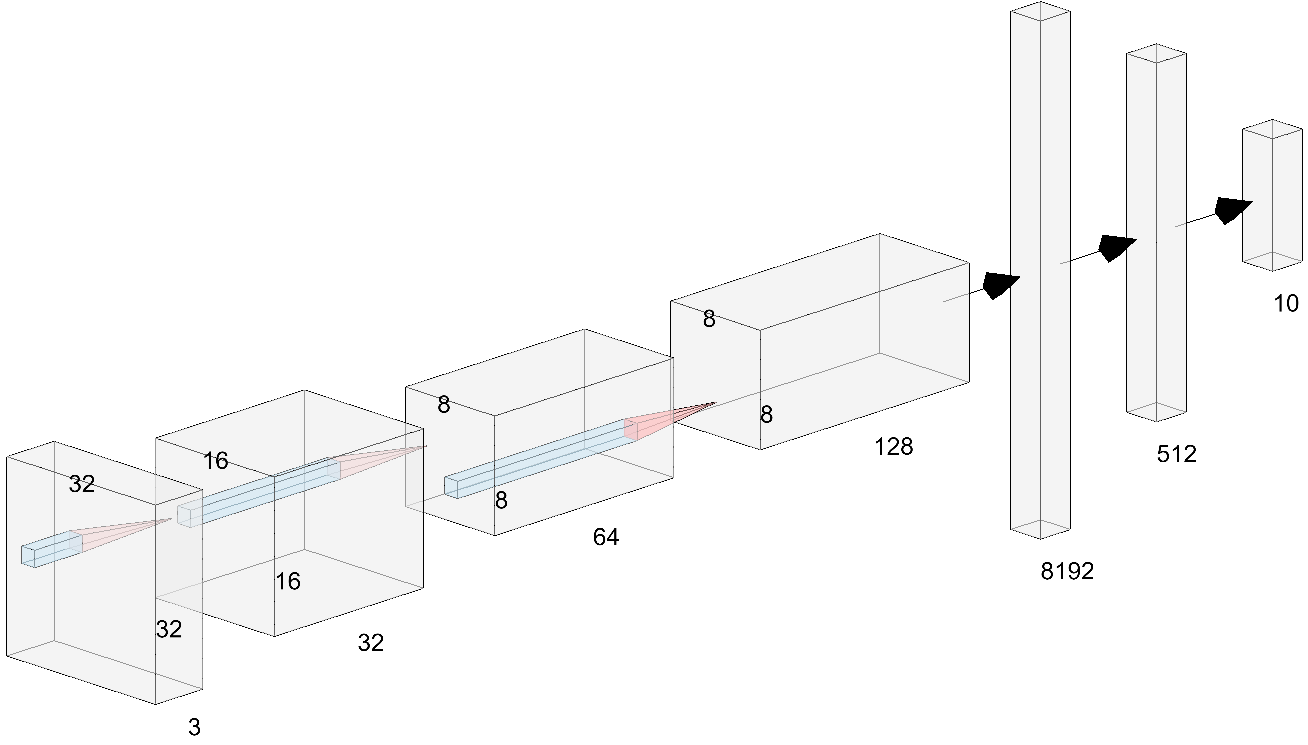
I layer di DROPOUT sono stati inseriti dopo entrambi gli ultimi due layer fully connected, subito dopo la non linearità; questo era l’approccio originale degli autori che hanno proposto questo tipo di layer12. Ricerche più recenti mostrano i vantaggi ottenibili usando questo tipo di layer anche dopo le prime convoluzioni, sempre dopo le non linearità, sebbene con valori di \(p\) molto più bassi, intorno a \(0.1-0.2\)13.
Lo scopo di questo tipo di layer è regolarizzare la rete, costringendola ad adattarsi a connessioni che vengono interrotte casualmente con probabilità \(p\) a ogni passo forward (e solo durante l’addestramento). La conseguenza è che a ogni passo di addestramento, il layer a cui è applicato il dropout viene visto e trattato come avente un numero di nodi e una configurazione diversi rispetto al passo precedente. Il risultato finale è approssimare o, meglio, simulare l’addestramento di più reti con architetture diverse, in parallelo.
Inoltre, un layer di BATCH NORMALIZATION è stato inserito dopo il primo layer fully connected per aiutare la convergenza e la stabilità della rete, attraverso il ri-centramento e il ri-scalamento dei suoi input14. Si riteneva che questa pratica riducesse l’internal covariate shift dei parametri, un problema legato all’inizializzazione della rete, ma studi più recenti mostrano che la ragione dell’aumento delle prestazioni non è dovuta a questo effetto di normalizzazione15. In una pubblicazione recente, si dimostra che usando una tecnica di clipping del gradiente e attraverso alcuni accorgimenti nel tuning di certi iperparametri, la necessità della batch normalization diventa marginale16.
Esperimenti
Sono stati eseguiti quattro diversi training:
1-2) ResNet-18:
- Ottimizzatore: Adam e SGD; scelto il modello migliore.
- Learning rate schedulato da \(1 × 10^{-3}\) a \(8 × 10^{-5}\)
- Loss: Cross Entropy
3) Custom net 1:
- Ottimizzatore: Adam
- Learning rate fisso a \(1 × 10^{-3}\)
- Loss: Cross Entropy
4) Custom net 2:
- Ottimizzatore: Adam
- Learning rate schedulato da \(1 × 10^{-3}\) a \(8 × 10^{-5}\)
- Loss: Cross Entropy
Tutte le reti sono state addestrate per un totale di 30 epoche, per una duplice ragione: da un lato, il tempo di addestramento iniziava a diventare quasi proibitivo per un numero maggiore di epoche; dall’altro, si è osservato che aumentare le epoche (e diminuire il learning rate, nelle esecuzioni con scheduler) non portava ulteriori benefici alla metrica di accuratezza sul test. Si sarebbe potuta implementare anche una tecnica di early stopping, ma si è ritenuto utile lasciare comunque completare al training tutte le 30 epoche programmate, sia per verificare che non accadesse nulla di anomalo, sia perché risultati migliori sarebbero ancora potuti emergere grazie alla continua diminuzione del learning rate.
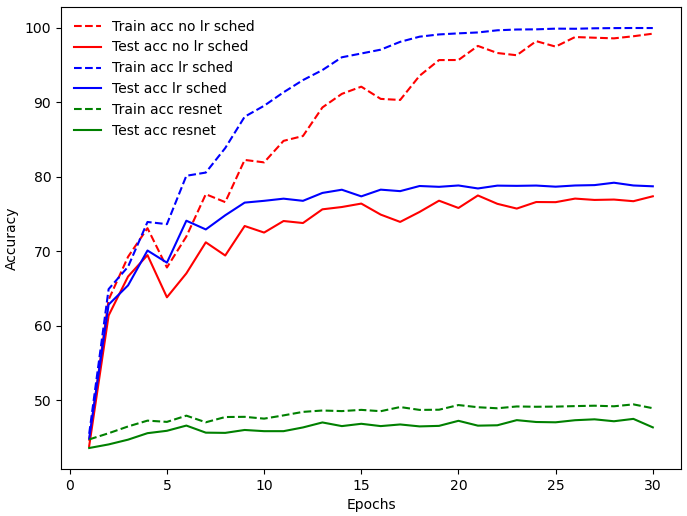
Risultati della rete custom. Analizziamo quindi i risultati in questo grafico: come possiamo vedere, dopo circa 10-15 epoche l’accuratezza sul test ha già raggiunto il suo valore finale, sia per il classificatore con lo scheduler del learning rate sia per quello senza, e si attesta intorno al 79% per la rete con scheduler contro il 77% per la rete senza. La differenza è piccola, ma rimane rilevabile lungo tutte le epoche di addestramento, dimostrando così l’utilità di ottimizzare con un learning rate progressivamente decrescente. Un’altra cosa da tenere in considerazione è che l’accuratezza sul training set sale fino al 99% in entrambi i casi, il che significa che i modelli vanno in completo overfitting sui dati di training.
Risultati del transfer learning con ResNet-18.
Quanto ai risultati ottenuti con la seconda architettura — quella che usa ResNet-18 come feature extractor — purtroppo lasciano molto a desiderare. Sebbene anche in questo caso sia stato usato un learning rate decrescente, l’accuratezza raggiunge quasi immediatamente il suo massimo: l’accuratezza sul test set è al massimo vicina al 48%, e quella sul train set si assesta intorno a un più stabile 50%. Cercando di indagare il problema, ho notato che la rete era stata pre-addestrata sul dataset ImageNet10 17, che consiste di milioni di immagini, divise in più di 20000 categorie. La teoria che ho quindi formulato è che la profondità relativamente contenuta della rete possa aver causato un collo di bottiglia nella capacità rappresentativa della rete stessa rispetto a una quantità così grande di informazione, ma è solo un’ipotesi.
Guardiamo ora le matrici di confusione: per l’architettura custom considereremo solo il modello che fa uso del learning rate progressivo, in quanto riporta risultati complessivamente migliori.
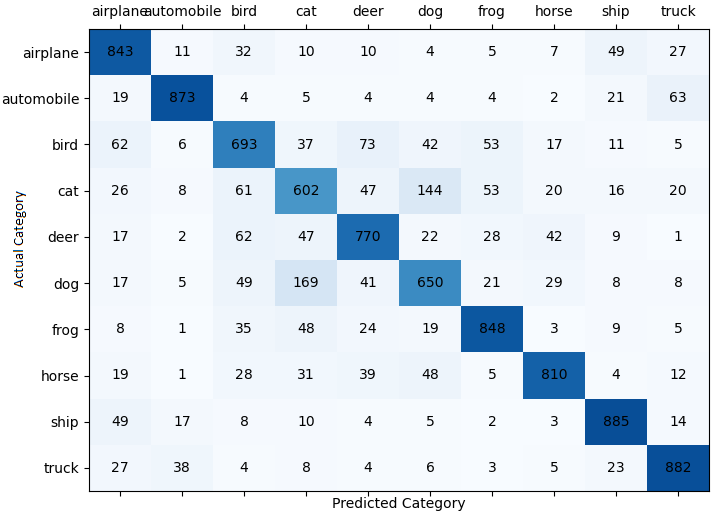
Come vediamo dalla Fig. 3, le classi sono identificate con una confidenza più che accettabile; data la loro bassa risoluzione, è interessante ma prevedibile vedere che le classi più facilmente confuse tra loro sono “cat” con “dog”, “airplane” con “bird” e “ship” (probabilmente a causa dello sfondo spesso prevalentemente blu), e “automobile” con “truck”, verosimilmente per alcune caratteristiche visive comuni, come ruote o portiere.
Come dimostra l’esempio mostrato in Fig. 4, non tutte le immagini sono significativamente diverse tra loro dal punto di vista visivo; alcune di esse possono facilmente essere classificate in modo errato anche dagli esseri umani18. Questo spiega i falsi positivi fuori dalla diagonale di questa matrice.
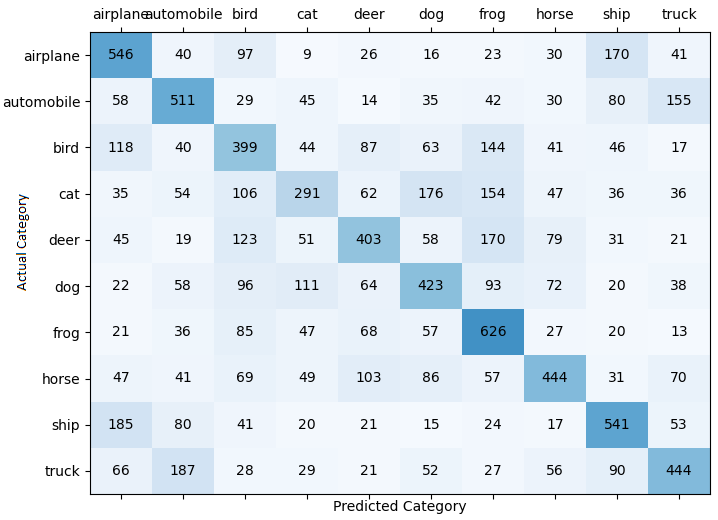
In quest’ultimo caso, come ci aspettavamo dati i risultati di accuratezza Top-1 in Fig. 2, il classificatore fatica molto di più a identificare correttamente le classi di appartenenza delle varie immagini. Si notano le stesse confusioni discusse sopra, ma molto più pronunciate, e si possono vedere anche degli outlier: se possiamo ben aspettarci che alcune immagini di “cat” a bassa risoluzione vengano scambiate per immagini di “dog”, certamente non ci aspettiamo che queste immagini di “cat” vengano identificate come “frog” con una frequenza pari alla metà di quella delle classificazioni corrette.
Sulla complessità computazionale. Ritengo importante menzionare la questione delle risorse computazionali: la rete convoluzionale custom vista in questo progetto non era certo al livello della profondità e delle prestazioni delle reti convoluzionali al vertice di competizioni come l’ILSVRC19. Come possiamo vedere dalla Fig. 520, più layer — e quindi più parametri — non significa automaticamente prestazioni migliori, in quanto potrebbe semplicemente significare più problemi durante l’ottimizzazione. In ogni caso, all’aumentare della profondità della rete si può indubbiamente raggiungere una maggiore capacità rappresentativa; cosa che non ho potuto sperimentare poiché già la sola aggiunta di un layer convoluzionale in più (portando quindi il totale a quattro) manifestava i limiti fisici del computer in mio possesso, nonostante disponesse di una scheda grafica con 2GB di memoria video dedicata. Con la configurazione appena vista, l’uso di memoria si aggira intorno a 1.3-1.5 GB durante la fase di training, con una batch size di 64 immagini. Riducendo questo iperparametro si può ridurre l’uso di memoria anche se, contrariamente alle mie aspettative, solo in modo piuttosto marginale.
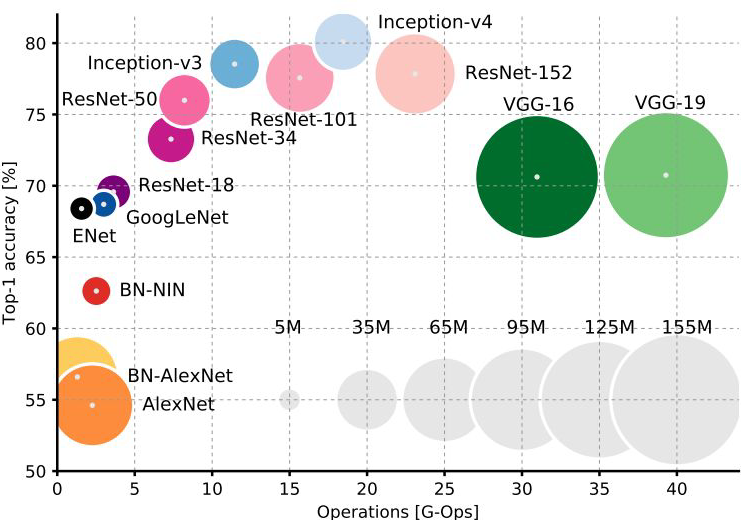
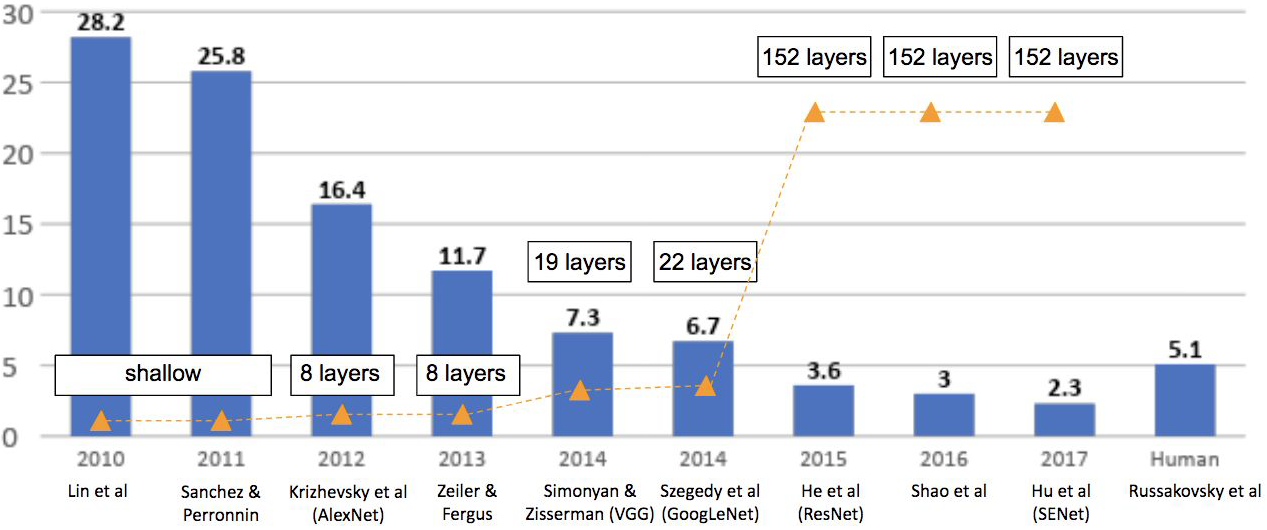
Sempre in relazione all’ILSVRC, possiamo vedere dalla Fig. 621 come con ResNet ci sia stata una “rivoluzione della profondità” delle reti convoluzionali: il numero di layer è esploso, e le prestazioni di classificazione sono raddoppiate. La vera rivoluzione, però, è che tutto questo non ha portato anche a un’esplosione dei parametri — e quindi della dimensione e della complessità delle reti; come possiamo vedere dalla Fig. 5, il numero di parametri e le operazioni richieste per il forward pass sono rimasti piuttosto contenuti, o addirittura diminuiti in alcuni casi.
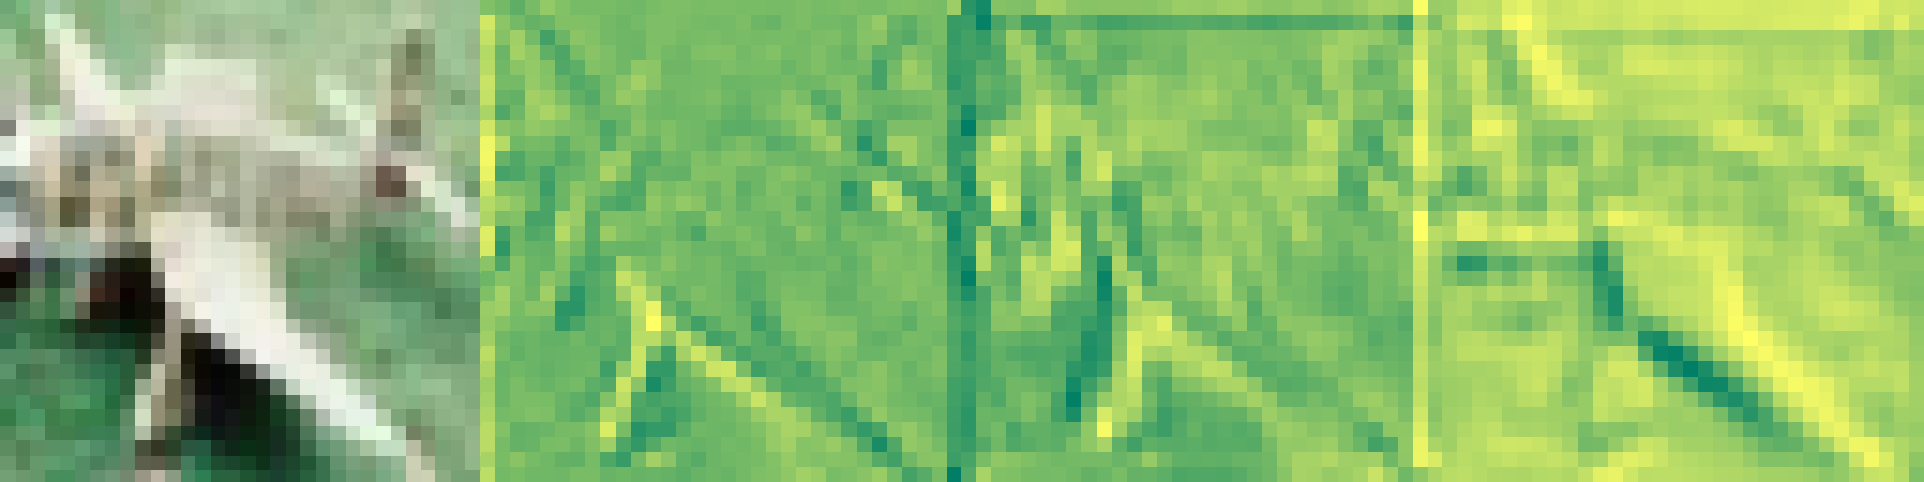
Infine, esploriamo visivamente alcune delle feature map estratte dal dataset. Dette anche “activation map”, esse indicano la risposta di attivazione di un dato filtro al passaggio di un’immagine attraverso la rete convoluzionale. In Fig. 7 possiamo vedere le risposte della feature map numero 6 nei vari layer, e come gli edge delle ali dell’aereo vengano resi sempre più pronunciati.
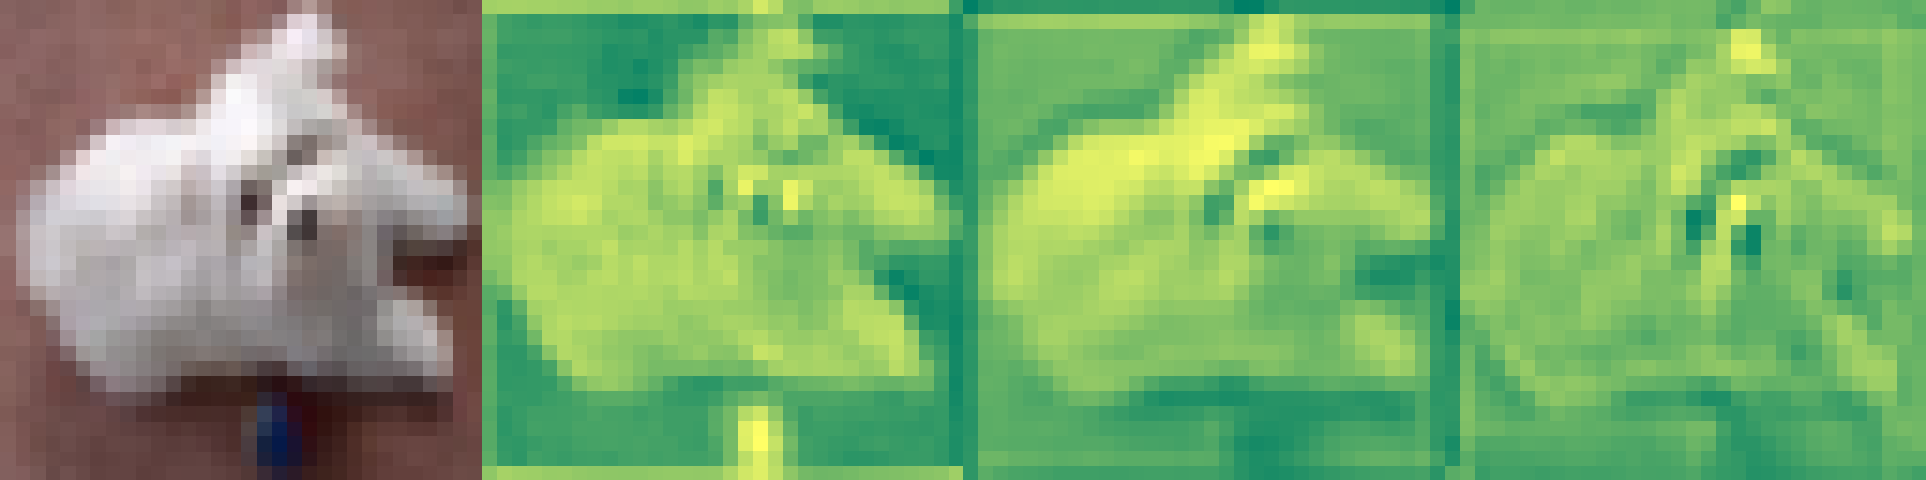
In Fig. 8, possiamo vedere come l'11ª feature map riesca a rimuovere alcuni degli elementi dello sfondo, in quanto non informativi per l’identificazione della classe dog, mantenendo al contempo una risposta elevata sui contorni del corpo del cane e sul muso.
Conclusioni
Dai risultati possiamo quindi concludere che anche una rete con un’architettura poco profonda, come quella custom discussa, può raggiungere un’accuratezza più che soddisfacente nonostante la sua natura semplice. D’altra parte, l’aumento della complessità e delle risorse computazionali richieste si è rapidamente rivelato un ostacolo alla sperimentazione, impedendomi di andare oltre i soli 3 layer convoluzionali.
Quanto alla rete ottenuta dalla ResNet pre-addestrata, le prestazioni sono purtroppo deludenti. Come discusso in precedenza, i pesi di tutti i layer di questa rete, eccetto l’ultimo fully connected, derivano da un addestramento su un dataset diverso da quello usato per il resto dell’esperimento, ossia ImageNet10. Solo l’ultimo layer denso è stato ri-addestrato per adattarsi al task; questo approccio, tuttavia, non si è rivelato produttivo. Ciononostante, questo non significa assolutamente che la tecnica del transfer learning non sia utile; significa piuttosto che andrebbe usata con più attenzione, ad esempio con un fine tuning dei parametri invece di mantenerli congelati — in altre parole, partendo da un minimo e, invece di rimanervi, muovendosi verso un minimo migliore attraverso più passi di ottimizzazione.
Infine, vale la pena menzionare che le classi che mettono più in difficoltà la rete sono, naturalmente, quelle visivamente più vicine, come cat e dog, o car e truck; e, per una questione di sfondo comune, anche airplane viene confuso un numero significativo di volte con immagini delle classi bird e ship; un esempio è quello mostrato in Fig. 4.
Un lavoro incrementale su questi risultati sarebbe concettualmente molto facile da realizzare, e potrebbe includere l’aumento del numero di layer convoluzionali, la rimozione di uno dei layer fully connected, e un miglior fine tuning dei parametri nel caso del transfer learning. In pratica, ciò richiederebbe risorse hardware aggiuntive, dato quanto discusso sopra.
The CIFAR-10 dataset
Alex Krizhevsky ↩︎80 Million Tiny Images: A Large Data Set for Nonparametric Object and Scene Recognition
W. T. Freeman and R. Fergus and A. Torralba ↩︎convolutional neural network image classification - Google Scholar
↩︎Very Deep Convolutional Networks for Large-Scale Image Recognition
Karen Simonyan and Andrew Zisserman ↩︎Imagenet classification with deep convolutional neural networks
Krizhevsky, Alex and Sutskever, Ilya and Hinton, Geoffrey E ↩︎Going Deeper with Convolutions
Christian Szegedy and Wei Liu and Yangqing Jia and Pierre Sermanet and Scott Reed and Dragomir Anguelov and Dumitru Erhan and Vincent Vanhoucke and Andrew Rabinovich ↩︎Deep Residual Learning for Image Recognition
Kaiming He and Xiangyu Zhang and Shaoqing Ren and Jian Sun ↩︎Identity Mappings in Deep Residual Networks
Kaiming He and Xiangyu Zhang and Shaoqing Ren and Jian Sun ↩︎GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism
Yanping Huang and Youlong Cheng and Ankur Bapna and Orhan Firat and Mia Xu Chen and Dehao Chen and HyoukJoong Lee and Jiquan Ngiam and Quoc V. Le and Yonghui Wu and Zhifeng Chen ↩︎Torchvision Models
The Torchvision library authors and community ↩︎ ↩︎ ↩︎Pattern Recognition and Machine Learning (Information Science and Statistics)
Bishop, Christopher M. ↩︎Improving neural networks by preventing co-adaptation of feature detectors
Geoffrey E. Hinton and Nitish Srivastava and Alex Krizhevsky and Ilya Sutskever and Ruslan R. Salakhutdinov ↩︎Analysis on the Dropout Effect in Convolutional Neural Networks
Park, Sungheon and Kwak, Nojun ↩︎Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift
Sergey Ioffe and Christian Szegedy ↩︎How Does Batch Normalization Help Optimization?
Shibani Santurkar and Dimitris Tsipras and Andrew Ilyas and Aleksander Madry ↩︎High-Performance Large-Scale Image Recognition Without Normalization
Andrew Brock and Soham De and Samuel L. Smith and Karen Simonyan ↩︎Imagenet: A large-scale hierarchical image database
Deng, Jia and Dong, Wei and Socher, Richard and Li, Li-Jia and Li, Kai and Fei-Fei, Li ↩︎Dopo averle chiesto di classificare le immagini della figura, una mia amica ha erroneamente etichettato le ultime due immagini rispettivamente come “gatto” e “cane”, invertendo quindi le classi.
↩︎ImageNet Large Scale Visual Recognition Challenge
Olga Russakovsky and Jia Deng and Hao Su and Jonathan Krause and Sanjeev Satheesh and Sean Ma and Zhiheng Huang and Andrej Karpathy and Aditya Khosla and Michael Bernstein and Alexander C. Berg and Li Fei-Fei ↩︎An Analysis of Deep Neural Network Models for Practical Applications
Alfredo Canziani and Adam Paszke and Eugenio Culurciello ↩︎Lecture 10: Recurrent Neural Networks
Fei-Fei Li and Justin Johnson and Serena Yeung ↩︎